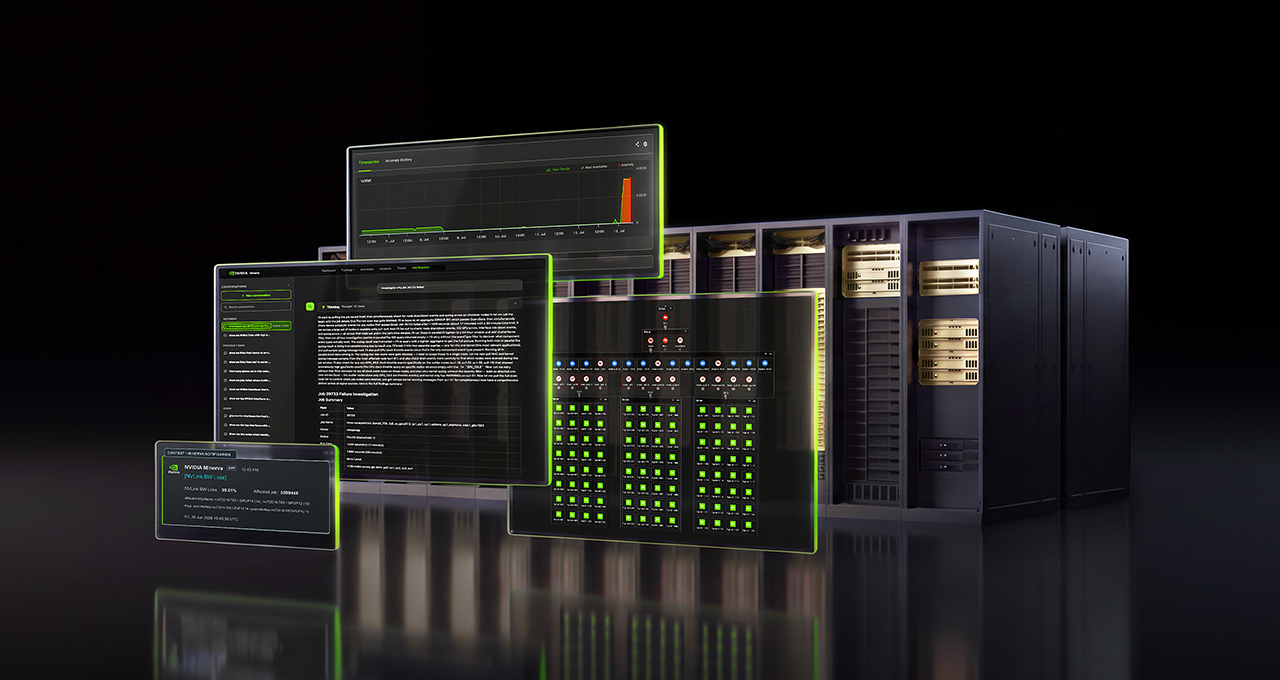
Se você trabalha com infraestrutura de IA, sabe o custo de um treino que para no meio.
A NVIDIA lançou hoje a Minerva, uma plataforma de observabilidade ponta a ponta voltada para fábricas de IA — os data centers que treinam modelos e servem aplicações em escala industrial. O anúncio foi publicado no blog oficial da NVIDIA.
A proposta é usar IA para cuidar da infraestrutura que roda IA.
Mas como monitorar uma operação com centenas de milhares de GPUs sem se afogar em alertas?
O problema que ninguém vê até tarde
> "Em fábricas de IA, um único componente degradado pode atrasar um trabalho inteiro."
Segundo o anúncio da NVIDIA, as fábricas de IA estão entre as operações mais complexas do mundo: vastas quantidades de GPUs trabalhando em redes de alta velocidade para treinar modelos e entregar aplicações.
Nessa escala, os sinais de alerta são fáceis de perder.
Uma GPU rodando mais quente que as vizinhas. Um drive NVMe perdendo desempenho sob carga. Detalhes pequenos que, somados, viram horas de produtivo jogadas fora.
O que a Minerva faz, afinal
A Minerva é uma plataforma AIOps — operações de TI assistidas por inteligência artificial. Ela reúne telemetria da infraestrutura e das cargas de trabalho de IA em um só lugar.
Em seguida, aplica modelos de IA construídos para esse fim, transformando esses dados em insights acionáveis em tempo hábil.
O foco declarado é o AI factory yield: uma medida do trabalho útil que a infraestrutura produz. Os indicadores citados são:
- GPU hours: horas de GPU efetivamente produtivas
- Goodput: throughput de trabalho útil
- Cluster uptime: tempo de disponibilidade do cluster
- Token production: produção de tokens
Como funciona por dentro
O grafo de conhecimento dinâmico
Ferramentas tradicionais de monitoramento costumam dividir o data center em visões separadas. Rede, computação, confiabilidade e times de machine learning cada um enxerga uma fatia diferente.
A Minerva conecta esses sinais across GPUs, rede, armazenamento, schedulers e workloads da NVIDIA.
Com esses sinais, ela constrói um grafo de conhecimento dinâmico que mapeia a infraestrutura — GPUs, SuperNICs, switches e cabos — e os jobs rodando nela.
Na prática, isso permite rastrear um job de treino lento até o componente que o está afetando, mesmo numa fábrica com centenas de milhares de GPUs.
Machine learning no comando
A plataforma analisa bilhões de pontos de dados por hora usando machine learning supervisionado e não supervisionado.
Ela aprende o comportamento normal, detecta anomalias nunca vistas, prevê falhas em ascensão e correlaciona eventos relacionados com base na topologia da fábrica.
E aqui está o pulo do gato: em vez de disparar cada sintoma para o operador, a Minerva agrupa uma tempestade de eventos em um único incidente focalizado, com uma causa raiz provável.
IA conversando com quem opera
A Minerva vem com um assistente de IA nativo e se conecta a ferramentas externas de IA agêntica.
Isso cria uma interface em linguagem natural fundamentada na telemetria em tempo real. Operadores podem investigar a saúde do cluster e receber recomendações de correção por conversa.
As equipes escolhem o nível de automação: manter uma pessoa no loop para aplicar correções manualmente, ou conectar a Minerva à automação via APIs de infraestrutura e sistemas externos.
Resultados: menos alerta, mais GPU ligada
Ok, mas o que isso entrega na prática?
De acordo com a NVIDIA, a capacidade de correlacionar problemas de workload e infraestrutura, junto com os recursos de IA agêntica, simplifica as operações das fábricas de IA.
Em vez de lidar com uma nevasca de alertas, a Minerva agrega problemas relacionados em um único item acionável.
Isso permite que times de AIOps saiam da manutenção reativa e migrem para a manutenção proativa.
E tudo isso converge para um objetivo: maximizar o uptime das GPUs.
Entre as métricas de valor citadas está o tempo mais longo entre interrupções: como a Minerva identifica problemas antes que aconteçam, os jobs rodam por mais tempo sem incidentes. O material divulgado menciona outras métricas, mas a lista completa não foi detalhada no conteúdo disponível.
O que fica de pé — e o que ainda não sabemos
O anúncio integra a sequência de comunicados da NVIDIA na Europa, conforme a página de anúncios da NVIDIA in Europe.
Agora, a parte honesta da reportagem: o que a fonte não menciona.
Não há informação sobre preço, disponibilidade, requisitos de implantação ou quais ambientes fora do ecossistema NVIDIA serão suportados. Também não há benchmarks públicos comparando a Minerva com ferramentas de observabilidade existentes.
O que está confirmado é o escopo técnico: telemetria unificada, grafo dinâmico da infraestrutura, modelos de ML para detecção e previsão, agregação de incidentes e interface conversacional.
O que não está confirmado é quando isso chega — e a quem.
Sem preço nem data, a Minerva da NVIDIA ainda precisa provar valor
Para quem opera fábricas de IA, a tese da NVIDIA é simples de entender: cada hora de GPU parada é dinheiro perdido, e os gargalos costumam aparecer como sintomas isolados antes de virarem incidentes.
A aposta da Minerva é transformar essa massa de sinais em contexto — e o contexto em ação rápida.
Sem preço, data de disponibilidade ou números de desempenho divulgados, cabe ao mercado testar se a promessa se sustenta fora do laboratório.
E você, a sua operação ainda descobre falhas quando o job já quebrou — ou antes?