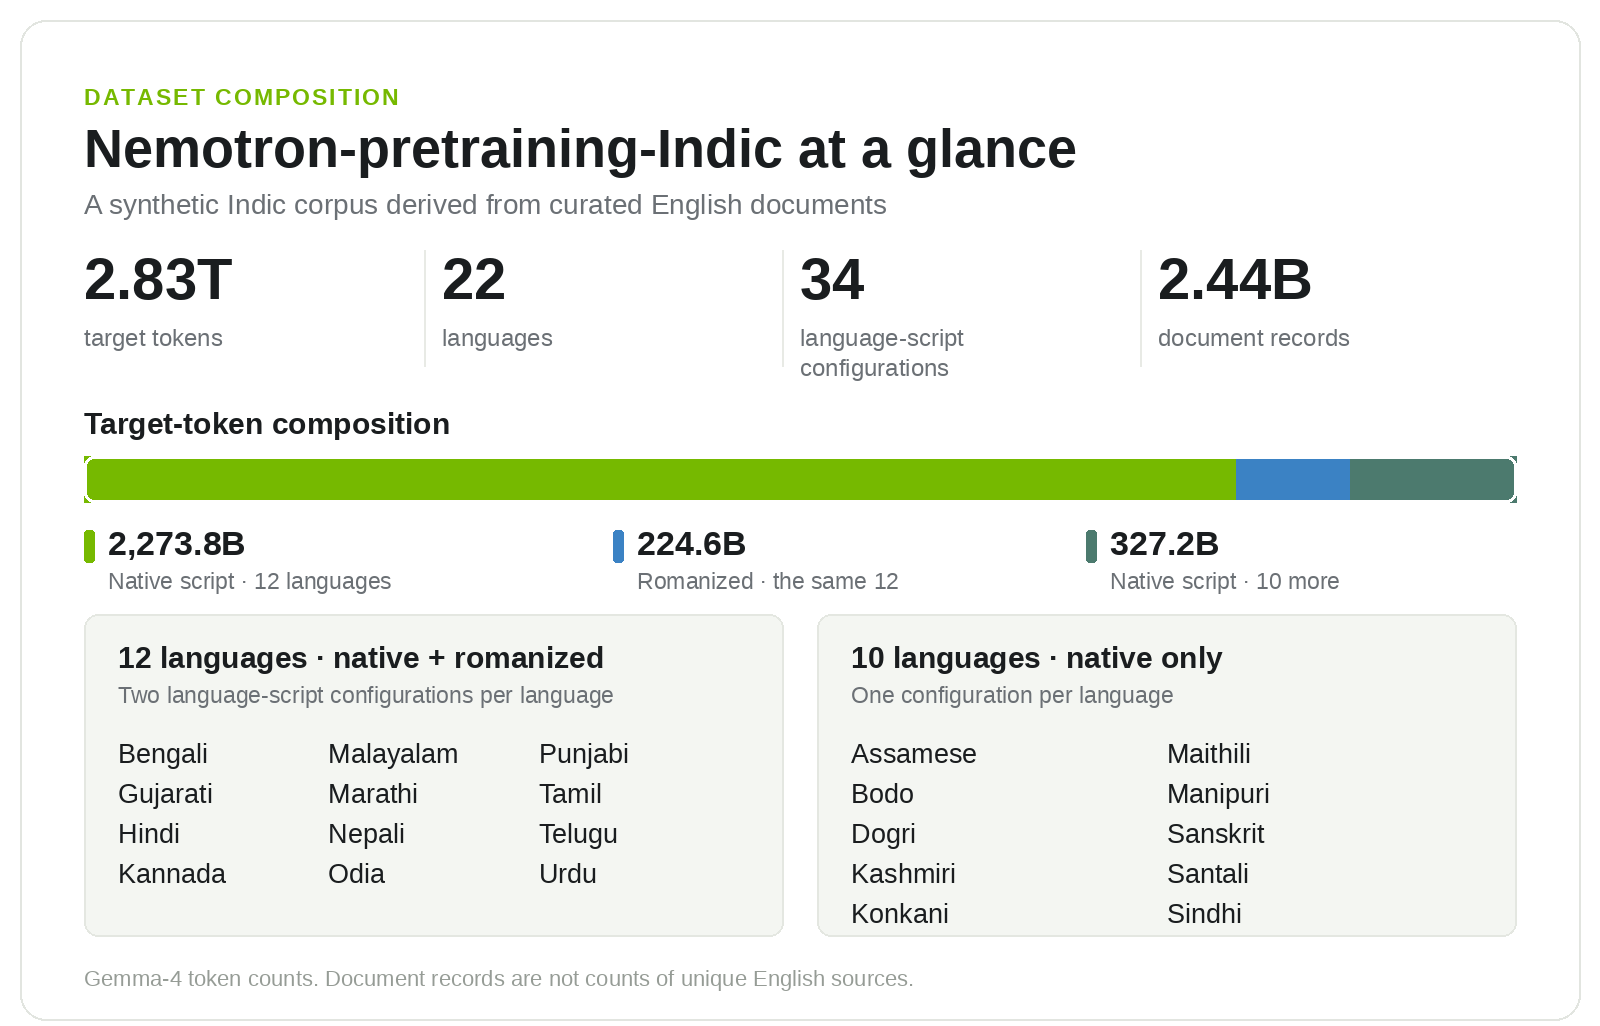
2,8 trilhões de tokens. Esse é o tamanho do novo corpus de pré-treinamento para línguas indianas anunciado pela NVIDIA.
Se você já tentou treinar ou ajustar um modelo para hindi, tâmil ou bengali, conhece o problema: dados de qualidade simplesmente acabam rápido. Esse anúncio mexe exatamente aí.
O dataset se chama Nemotron-pretraining-Indic-v1 e cobre 22 idiomas oficiais da Índia.
O detalhe que chama atenção: todo o pipeline de geração de dados também será aberto.
Quanto é 2,8 trilhões de tokens, na prática? Para efeito de comparação, está na faixa dos maiores corpora de pré-treinamento já publicados em línguas de baixos recursos — e é a primeira vez que um volume desse tamanho cobre o conjunto completo de línguas oficiais indianas.
Por que 22 idiomas importam
Segundo o anúncio original, as 22 línguas são as listadas na Constituição indiana.
Elas são a primeira língua de 97% dos indianos — quase 1,2 bilhão de pessoas no Censo de 2011.
> "São 2,8 trilhões de tokens em 22 línguas indianas, com pipeline aberto de geração de dados acelerado por GPU."
Na prática, isso endereça um problema conhecido da comunidade de ML: a escassez de dados de pré-treinamento de qualidade para idiomas de baixos recursos. A parceria entre a NVIDIA e o AI4Bharat, laboratório do IIT Madras, uma das principais instituições de engenharia do país, busca justamente preencher essa lacuna.
O que o pipeline entrega
O trabalho foi construído em três frentes complementares, conforme descrito pelos autores:
- Dados em escrita nativa: cobertura para as 22 línguas
- Dados romanizados: disponíveis para doze idiomas
- Pipeline reutilizável: acelerado por GPU, cobrindo tradução, avaliação de qualidade e reparo de dados
Para engenheiros de ML, o ponto mais relevante é a reprodutibilidade. A receita aberta de geração está disponível no repositório do projeto no GitHub, permitindo que outros times adaptem o fluxo de tradução, controle de qualidade e correção para seus próprios corpora.
Escala e o que ainda não sabemos
O anúncio foi publicado em 16 de outubro de 2026, com autores das equipes da NVIDIA e do AI4Bharat, incluindo Mohammed Safi Ur Rahman Khan, Mitesh Khapra e Anoop Kunchukuttan, pelo lado do AI4Bharat.
A fonte não menciona benchmarks de modelos treinados com o dataset, nem resultados de qualidade comparados com outros corpora multilíngues.
Também não há informação sobre data exata de disponibilidade: o texto indica apenas que o lançamento do dataset e do pipeline acontecerá "em breve" (releasing soon).
O que o Nemotron-pretraining-Indic-v1 muda para quem treina LLMs
Se você treina ou ajusta LLMs para idiomas indianos, um recurso de pré-treinamento em escala trilhonária de tokens muda o ponto de partida.
E como o pipeline é aberto, a mesma receita pode ser estendida a outros idiomas de baixos recursos.
A pergunta que fica: com dados abundantes e pipelines abertos, quanto tempo até os modelos Indic alcançarem o estado da arte em benchmarks globais?
A fonte não apresenta essa projeção — mas a infraestrutura para chegar lá acabou de ficar pública.
E você, já trabalhou com corpora Indic ou com outros idiomas de baixos recursos? Conta nos comentários como foi lidar com a escassez de dados — e se um dataset desse tamanho resolveria o seu caso.