Se você já pediu código para uma IA, conhece o problema: ela adora escrever demais.
O modelo realmente precisava de tantas linhas para resolver um bug simples?
O Parsimony quer medir exatamente isso. A ferramenta open-source avalia quanto código um agente de IA adiciona de verdade, em uma iniciativa comunitária publicada no Hacker News.
O que o Parsimony mede
Segundo o GitHub do projeto, benchmarks existentes avaliam apenas taxa de resolução e custo operacional. Por outro lado, nenhum deles penaliza soluções infladas, o que torna qualquer repositório difícil de manter no longo prazo.
O Parsimony entra justamente nessa lacuna.
> "Lines aren't counted, so cramming code isn't rewarded, and deleted code is subtracted: net units = added − removed."
A ferramenta contabiliza unidades reais de código: statements, chamadas de função, comparações, identificadores e literais. Contar linhas brutas não faria sentido, já que premiaria quem apenas espreme comandos no mesmo espaço. Da mesma forma, código deletado é subtraído da conta final: net units = added − removed.
Como funciona a comparação
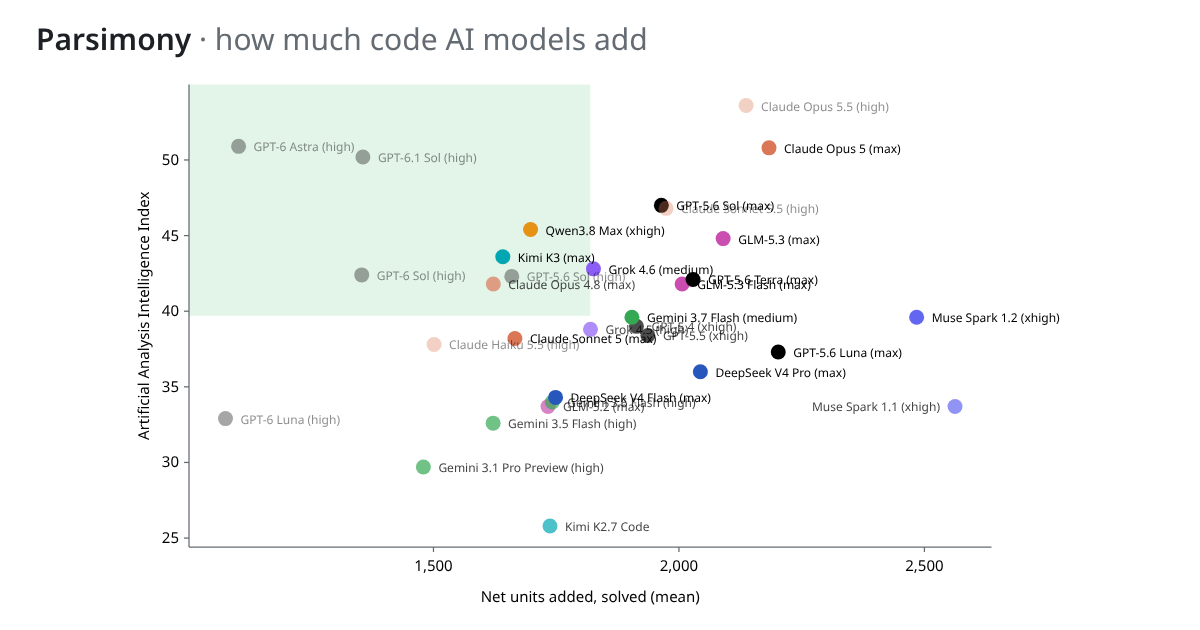
Na prática, o Parsimony pega os patches que outros benchmarks já publicam e aplica essa régua de contagem. Os modelos são ranqueados pela média de net units adicionados nas tarefas que concluíram com sucesso, onde números menores indicam maior eficiência.
A métrica "Net units added (mean)" também inclui tentativas que falharam. Já o campo "Solved" aproveita diretamente os dados do SWE-bench Verified, sem reexecutar testes.
Além disso, a coluna "Measured" indica quantas tentativas resolvidas puderam ser medidas. O Artificial Analysis Intelligence Index aparece apenas como referência externa e não interfere na classificação.
O que os gráficos mostram
Os gráficos e o leaderboard dependem de JavaScript para renderizar na página. Para quem prefere auditar os números, os dados brutos ficam disponíveis no GitHub em gráficos de dispersão ou barras simples.
Modelos com visual desbotado na tabela foram executados pelo próprio autor nas primeiras 3 a 10 tarefas do DeepSWE Python. Nesses testes informais, os modelos da OpenAI rodaram via pi e os da Anthropic via Claude Code, sem validação oficial no ranking.
Um caso curioso envolveu o GPT-5.6 Sol: a execução manual do autor gerou apenas 0.88× o código da versão submetida oficialmente.
O impacto do Parsimony na escolha de modelos de IA
Para quem coloca agentes de código em produção, essa métrica altera o critério de escolha. Resolver o problema é o piso básico; o diferencial é entregar a correção sem poluir a base existente. Código redundante vira dívida técnica imediata na fila de code review.
O projeto segue aberto e aceita submissões da comunidade, conforme detalhado na documentação oficial.
Você já precisou rejeitar o patch de um agente de IA simplesmente porque ele escreveu código demais para resolver algo pontual?